前言

这项工作在大约三个月前完成,但我迟迟懒于公布,大概是因为它“食之无味,弃之可惜”吧。草草收个尾好了。

Mel 频谱是绝大部分深度学习算法处理音频的第一步,使用广泛,但由于这一步在总体耗时中的占比过小,一直没有人进行优化。这正好是一个用来练习算子开发技能的机会。

FlashMel 的初版由我手工设计(这大概会是我手工设计的最后一个算子了),但 Claude Fable 5 发布之后,我发现仅仅加以几句点拨,agent 就能从头实现一个性能超过我 10%,逼近此方法的硬件上限的版本。我顿时失去了对这个项目的兴趣,连续几个月没再碰它。

我个人的叙述就到此为止;以下内容由 Claude Opus 5.5 撰写。

介绍

FlashMel 是一个 CUDA 实现的 mel 频谱图(mel spectrogram)算子,接口与 torchaudio.transforms.MelSpectrogram 相同,可以直接替换。它把分帧、补边、加窗、实数 FFT、取模平方和 mel 滤波器组投影合并到一次 kernel launch 里。在 RTX 4070 Laptop 上,它比 torchaudio 快 5 到 16 倍,fp32 输出与 torchaudio 的误差在 atol = rtol = 1e-4 以内。

名字借自 FlashAttention,两者的出发点相同:不把中间结果写回显存(HBM)。不同之处在于,attention 的中间矩阵在行方向上相互依赖,需要 online softmax 这类技巧才能分块计算;mel 频谱图的各帧彼此独立,融合本身没有算法上的障碍。真正的问题出现在融合之后:一个 kernel 里同时有访存、FFT 和稀疏归约,瓶颈落在哪一处,取决于参数。

本文先简单介绍 mel 频谱图和 FlashMel 的数据流,然后以 Whisper 的配置为例,看每一步优化分别解决了哪个瓶颈,最后看换到其他 FFT 尺寸时瓶颈如何变化。阅读本文只需要熟悉 CUDA 编程模型,不需要音频背景。

mel 频谱图

音频是一维的采样序列。mel 频谱图的计算分四步:

  1. 分帧:每隔 \(H\) 个采样取一段长为 \(N\) 的窗口。\(N\) 即参数 n_fft,\(H\) 即 hop_length。Whisper 使用 16 kHz 采样,\(N = 400\)(25 ms),\(H = 160\)(10 ms),相邻帧重叠 60%。center=True 时,信号两端先各补 \(N/2\) 个采样,默认用反射(reflect)方式补齐。
  2. 加窗并做实数 FFT:每帧乘以 Hann 窗后做 FFT,得到 \(N/2+1\) 个频点。
  3. 取功率:每个频点取 \(|X|^2\)。
  4. mel 投影:用 \(M\) 个三角形滤波器(Whisper 为 128 个)对功率谱加权求和。

写成公式:

\[ Y[m, t] = \sum_{k=0}^{N/2} F[m,k]\,\Bigl|\sum_{n=0}^{N-1} w[n]\,x[tH + n - N/2]\,e^{-2\pi i kn/N}\Bigr|^2 \]

从计算的角度,有三点值得注意:

  • 帧与帧互相独立,天然适合并行。
  • 滤波器矩阵 \(F\) 的形状是 \(M \times (N/2+1)\),但每一行只在一段连续区间上非零,所以投影实际上是一组很短的稀疏点积。
  • 算术强度(arithmetic intensity)很低。以 Whisper 为例,每帧只需要读入 \(H = 160\) 个新采样(640 B),写出 128 个 mel 值(512 B);一次 400 点 FFT 按 \(5N\log_2 N\) 估算约为 1.7 万次浮点运算,合约 15 FLOP/B。按这张卡的标称 FP32 峰值估算,roofline 的拐点(ridge point)在 100 FLOP/B 左右。因此,至少在理论上,这个算子应当受访存带宽限制。

一个 kernel 完成全部计算

torchaudio 的实现由 torch.stft 和一次矩阵乘组成,中间的复数频谱和功率谱都要完整写回 HBM,再由下一步读入。FlashMel 用 cuFFTDx 把所有步骤合并进一个 kernel。cuFFTDx 是 NVIDIA 的设备端 FFT 库:FFT 由一个 block 内的线程协作完成,输入和输出都放在寄存器里,所以 FFT 前后可以直接接自定义代码。cuFFT 做不到这一点,它只能从主机端 launch,输入输出都必须在显存里。

cuFFTDx 的 FFT 尺寸、每个 block 处理的帧数(下文记作 FPB,frames per block)等参数都是编译期常量。因此 FlashMel 在运行时用 NVRTC 为每种参数组合单独编译 kernel,并把 cubin 缓存在磁盘上,首次使用某个配置约需 2 秒。

一个 block 负责同一条音频上连续的 FPB 帧,数据流如下:

flowchart LR
    A["HBM:音频采样"] -->|"分帧、补边、加窗"| B["寄存器"]
    B -->|"cuFFTDx block FFT"| C["寄存器:频谱"]
    C -->|"取模平方"| D["共享内存:功率谱 tile"]
    D -->|"稀疏 mel 投影"| E["HBM:mel 输出"]

有几个细节:

  • 补边不会物化。center 引入的补边、pad 参数以及四种 pad_mode,都换算成读入时的下标运算。分帧后的信号从头到尾都不存在于显存中。
  • STFT 的 normalized 选项只是给窗函数乘一个常数,所以在主机端预先乘进窗函数。
  • n_fft 为 2 的幂时,使用 cuFFTDx 的 folded 模式:把 \(N\) 个实数看作 \(N/2\) 个复数,做 \(N/2\) 点复数 FFT,共享内存和蝶形运算都减半。400 不是 2 的幂,cuFFTDx 的 folded 模式不支持这个尺寸,只能用 normal 模式,即把实数输入当作虚部为零的复数,做完整的 400 点复数 FFT。后文会看到,这是 Whisper 配置的特殊之处。
  • FFT 执行完后,它在共享内存中的工作区不再有用,直接改作功率谱 tile,供投影阶段读取。

最后一点对应的代码如下(简化自 kernel.cu):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
constexpr unsigned N_FREQS = N_FFT / 2 + 1;
// 所有支持的 n_fft 都是偶数,所以行宽 N_FREQS 必为奇数
constexpr unsigned PSTRIDE = N_FREQS;
static_assert(PSTRIDE % 2 == 1);

FFT().execute(thread_data, reinterpret_cast<complex_type*>(smem_raw));
__syncthreads();

// FFT 的共享内存工作区已经用完,原地改作功率谱 tile
float* prow = power + threadIdx.y * PSTRIDE;
for (unsigned i = 0; i < FFT::output_ept; ++i) {
const unsigned idx = threadIdx.x + i * FFT::stride;
if (idx < N_FREQS) prow[idx] = spec_value(thread_data[i]);
}
__syncthreads();

tile 的每一行存一帧的功率谱,行宽取 \(N/2+1\)。因为行宽是奇数,相邻帧的同一频点会落在不同的 bank 上,不需要额外补齐就能避免 bank conflict。奇数行宽还有一个副作用,讲到中等尺寸时会再提。

投影阶段,滤波器以稀疏格式存储:每个滤波器记录起点 start[m]、宽度 width[m] 和一段长为 W_MAX 的权重,W_MAX 是最宽滤波器的宽度。线程按(mel 序号,帧序号)分配输出,相邻线程计算同一 mel 行上的相邻帧,所以写回 HBM 时是合并访问(coalesced access)。

Whisper:从延迟受限到带宽受限

先说明测量方式。所有数据都来自一台 RTX 4070 Laptop(sm_89),实测显存拷贝带宽约 198 GB/s,下文称为拷贝峰值。计时使用 CUDA event,取 50 次的中位数。笔记本的温度会让结果浮动约 15%,所以下面每一步优化的比值都来自同一进程内交替运行的 A/B 对比,不同时间测得的绝对耗时之间不做比较。瓶颈分析使用 Nsight Compute 的 SOL(speed of light)指标,即各硬件单元的吞吐量占其峰值的百分比。

Whisper 的标准配置是:n_fft = 400,hop_length = 160,128 个 mel,30 秒音频(480000 个采样),batch 为 32。FlashMel 最终耗时 0.54 ms,比 torchaudio 快 11.7 倍。按必要字节计算(输入和输出各计一次,共约 110 MB),有效带宽为 205 GB/s,达到拷贝峰值的 103%。有效带宽之所以能超过拷贝峰值,是因为相邻帧有重叠,每个采样平均被 2.5 帧读取,重复的读取大多命中了 L2,而必要字节只把输入计算一次。

下面看它是怎样走到这一步的。

第一步:共享内存限制了占用率

最初每个 block 处理 8 帧。normal 模式要做完整的 400 点复数 FFT,每帧的工作区是 400 × 8 B = 3.2 KB,8 帧共 25.6 KB,每个 SM 只能容纳 3 个 block。Nsight Compute 的结果是:DRAM 43%,SM 35%,占用率(occupancy)31%,限制因素为共享内存。

把 FPB 降到 4 后,每个 block 的工作区减半为 12.8 KB,每个 SM 能容纳 7 个 block,占用率升到约 42%,速度提升 1.14 倍。

但此时 DRAM 和 SM 的 SOL 仍然都只有 47% 到 48%,没有任何一个单元跑满。这是典型的延迟受限(latency-bound):warp 大部分时间在等待,而能用来掩盖等待的 warp 又太少。占用率的上限由 normal 模式的工作区决定,而 400 点只能使用 normal 模式,所以从占用率入手已经走不下去了。剩下两个方向:减少每帧的计算量,或者减少每个 warp 的等待。

失败的尝试:两帧共用一次 FFT

normal 模式浪费了一半的计算量,因为输入的虚部全是零。一个经典的办法是把两帧打包进一次复数 FFT:帧 \(a\) 作实部,帧 \(b\) 作虚部,即 \(z = a + ib\),然后利用共轭对称性把两帧的频谱分开:

\[ A[k] = \frac{Z[k] + \overline{Z[N-k]}}{2},\qquad B[k] = \frac{Z[k] - \overline{Z[N-k]}}{2i} \]

这样蝶形运算和每帧的工作区都减半了。这个方案实现后通过了正确性测试,但在同一进程内交替运行的 A/B 对比中,它反而慢了约 1.5 倍。

原因有两个。第一,分离频谱时要同时用到 \(Z[k]\) 和 \(Z[N-k]\),它们通常不在同一个线程的寄存器里,所以完整的 \(Z\) 必须先写进共享内存再读出来,多了一次共享内存往返。cuFFTDx 中一次 400 点 FFT 由 20 个线程协作完成,这些线程组会跨越 warp 的边界,所以也无法改用 warp shuffle 交换数据。第二,参与 FFT 的线程数减半,能用来掩盖延迟的并行度也随之减少。对一个延迟受限的 kernel 来说,减少浮点运算本来就帮不上忙,而这个方案还增加了访存、降低了并行度。

第二步:让绝大多数帧跳过边界处理

既然瓶颈是等待,就要看 warp 在等什么。原先的实现中,每个采样都要经过 load_sample:先处理反射,再减去 pad 偏移,再判断是否越界,然后才能算出地址、发出访存。每个采样都要执行这样一串相互依赖的比较和选择,而占用率只有约 41%,没有足够多的 warp 来掩盖这段延迟。

实际上,需要做边界处理的帧非常少。Whisper 配置下,一个帧只有伸出信号两端时才需要处理边界,每条音频的首尾各只有 2 帧,在 3001 帧中只占 4 帧。所以 kernel 改为按整帧判断:只要整帧都落在原始信号内部,就直接读取(简化自 kernel.cu,以 fp32 输入、reflect 模式为例):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// 通用路径:每个采样都要做一次边界处理
__device__ float load_sample(const float* x, int v, int L, int n, int pad) {
v = v < 0 ? -v : v; // 左端反射
v = v >= L ? 2 * L - 2 - v : v; // 右端反射
v -= pad;
if (v < 0 || v >= n) return 0.f; // pad 区域补零
return x[v];
}

// 整帧位于信号内部:直接读取,没有任何逐采样的边界逻辑
if (valid && base >= pad && base + N_FFT <= pad + n_samples) {
for (unsigned i = 0; i < FFT::input_ept; ++i) {
const unsigned idx = threadIdx.x + i * FFT::stride;
reg[i] = idx < FFT::input_length ? xf[idx] * window[idx] : 0.f;
}
} else {
for (unsigned i = 0; i < FFT::input_ept; ++i) {
const unsigned idx = threadIdx.x + i * FFT::stride;
reg[i] = (valid && idx < FFT::input_length)
? load_sample(x, base + idx, L, n_samples, pad) * window[idx]
: 0.f;
}
}

这个判断对每一帧只做一次,只有每条音频首尾的 block 里才会出现分支发散。改动后速度提升 2.0 倍。Nsight Compute 显示 DRAM 77%、L1 80%、SM 74%,其中 77% 的理论 DRAM 带宽大致就是实测的拷贝峰值。也就是说,Whisper 配置此时已经受 DRAM 带宽限制。占用率仍然是 41%,但它已经不再是瓶颈了。

换一个尺寸,瓶颈就变了

Whisper 最终停在 DRAM 带宽上,但这只是 FlashMel 所支持的尺寸中的一种情况。n_fft 增大时,每帧 FFT 的计算量按 \(N\log N\) 增长,每帧读写的字节数大致按 \(N\) 增长,所以算术强度随 \(\log N\) 缓慢上升;与此同时,block 级 FFT 需要的共享内存和同步次数也在增长。下表是几种典型配置的最终状态:

配置n_fft / hopmel 数相对 torchaudio 的加速比最终瓶颈
small64 / 16405.6×DRAM
Whisper400 / 16012811.7×DRAM
speech1024 / 2568016.2×L1 与共享内存
music4096 / 102425612.9×L1 与共享内存
huge16384 / 40962565.0×占用率与 barrier

小尺寸(64 到 512):DRAM

在 hop = n_fft / 4 的扫描中,64 到 512 的有效带宽达到拷贝峰值的 97% 到 120%。原因与 Whisper 相同:每个采样被 4 帧重复读取,重复的部分由 L2 承担。

不过,小尺寸并不是一开始就达到了带宽上限。帧很短时,每字节数据对应的访存指令很多,瓶颈在访存单元(LSU)的指令吞吐上,而不在 DRAM。folded 模式按(偶数位,奇数位)成对消费采样,而这两个采样在内存中正好相邻。因此,对于不涉及边界的帧,信号和窗函数都改用 float2(int16 输入则用 short2)一次读两个,访存指令数减半,64 点的耗时减少了 30%。这里有一个陷阱:对齐检查必须检查实际的指针,而不是下标的奇偶性。当每条音频的长度为奇数时,每隔一行的起始地址都会偏移 4 字节,只看下标会触发 misaligned address 错误。

中等尺寸(1024 到 4096):L1 与共享内存

这个区间内 DRAM 的 SOL 只有 30% 到 40%,L1 与共享内存则达到 76% 到 81%。

第一次分析 1024 点配置时,L1 与共享内存的 SOL 高达 89%,其中很大一部分来自 mel 投影:每个点积都按 W_MAX 的长度读取补零后的整行权重。mel 刻度上,高频滤波器很宽,低频滤波器很窄,而 W_MAX 是由最宽的那个决定的,大多数滤波器的实际宽度远小于它。改为按每个滤波器的实际宽度 width[m] 循环后,1024 点快了 1.22 倍,4096 点快了 1.39 倍,这是所有优化中单项收益最大的一次。Whisper 的滤波器都很窄(W_MAX ≤ 16),所以保留了按 W_MAX 完全展开的循环。

剩下的 L1 流量主要来自 cuFFTDx 内部线程间的数据交换,FlashMel 无法控制。自己这边还能想到的优化,比如把投影阶段的共享内存读取向量化,会与前面的奇数行宽冲突:奇数行宽让各行的起始地址无法满足 8 字节或 16 字节对齐,所以避免 bank conflict 与向量化读取只能二选一。把输入先暂存到共享内存的方案同样不可行,因为共享内存和 L1 共用同一条 LSU 流水线,这样做只是把流量从一处挪到另一处,总量并没有减少。

大尺寸(8192 和 16384):占用率与 barrier

这个区间的 FFT 工作区为 33 KB 到 64 KB,每个 SM 只能容纳 1 到 2 个 block。block 级 FFT 内部有多次 __syncthreads,每到一次 barrier,整个 SM 上的 warp 几乎都在等待,没有别的 block 可以调度。以 16384 点为例,按前面的方法估算,算术强度约为 30 FLOP/B,仍在拐点左侧,但它既没有跑满 DRAM(有效带宽 33 GB/s),也没有跑满计算单元。roofline 的两条上限都描述不了这种情况,真正限制它的是并行度和同步。

在这个前提下,能做的是不让线程闲着。16384 点的 block 有 1024 个线程,而每个 block 只处理 1 帧,只有 256 个 mel 输出,投影阶段有四分之三的线程无事可做。改为由多个线程(代码中的 SPLIT)合作计算一个点积,最后用 __shfl_down_sync 做 warp 内归约,16384 点又快了约 12%。外层循环对 warp 内的所有线程保持一致,这样全掩码的 shuffle 始终合法。

再往前走,要么把 FFT 拆成多个 kernel,频谱就必须写回 HBM,融合的前提也就不存在了;要么改用 fp16 旋转因子(twiddle factor),精度又无法满足 1e-4 的要求。

小结

各尺寸的最终状态如下:

  • 64 到 512 以及 400(Whisper)受 DRAM 带宽限制,有效带宽达到或超过拷贝峰值。
  • 1024 到 4096 受 L1 与共享内存吞吐限制,SOL 为 76% 到 81%,剩余流量来自 cuFFTDx 内部。
  • 8192 和 16384 受占用率和 barrier 限制,继续优化需要放弃单 kernel 结构或 fp32 精度。

目前的限制:n_fft 必须是 400 或 64 到 16384 之间的 2 的幂,n_mels 不超过 256,窗函数固定为 Hann 窗,只支持推理,不支持反向传播。
彩蛋

让模型用一首押韵诗讲解自己的优化历程。

Four hundred samples, windowed tight,
ride registers into the night;
no frame shall touch the HBM —
the L2 cache remembers them.

The macro EPT broke the build
(a template name already filled);
renamed, recompiled, and then —
the spectra matched at one-e-minus-ten.

We folded radix, halved the share,
of memory each block must bear;
we swept the FPB by twos
and read what Nsight said to choose.

The paired-FFT, our cleverest scheme,
drowned in shared memory's stream —
half the math, yet slower still:
a tombstone on profiling hill.

But width-bound loops cut traffic deep,
the mel bins now coalesce in sleep;
torchaudio takes six millis flat —
we're done in point-eight. Mind the gap.

So here's to kernels fused as one,
to tests all green, to sweeps all run;
the bandwidth roofline, nearly kissed —
the rest is cuFFTDx's twist.

(Epilogue, round two)
Then back we came with sharper knives:
let idle threads lead useful lives —
four lanes per mel, a shuffled sum,
and sixteen-k stopped looking glum.

The folded pairs, loaded as two,
cut instructions clean in half — it's true;
but mind the rows of odd-length sound,
or misaligned your loads are found.

Now small sizes drink the DRAM dry,
the middle pins the LSU high,
the giants wait at barrier walls —
and that is where the curtain falls.

在上一篇中,我们讨论了主流的 harness 功能。自然地,我们想知道:未来的 harness 需要哪些功能?

真正重要的能力

首先做一个概念上的区分:本文所讨论的 harness 功能不包括提示词。AGENTS.md、skills 之类提示词组件远比 harness 本身更易采用和替换,因此 harness 不应捆绑大量的提示词。提示词工程与模型共同演进的问题超出了本文的范围,此处不作展开。

有很多人认为我们不需要额外的 harness 功能:随着模型能力的增强,许多功能都将变得不再必要。但我觉得并非如此。诚然,有一些功能完全是为了给能力不足的模型一些(提示性或强制性的)辅助,而当这些功能已经被更强的模型内化之后,他们在 harness 中的存在就显得多余。 但我认为有两类功能不在此列,无关模型能力如何:

  • 本质能力:如果 harness 不提供,agent 便无法获得的能力比如说很多 harness 不允许 agent 通过 tool call 重新加载自己的插件,这使得 agent 完全无法写 MCP 给自己或自己的 subagent 使用1。
  • 经济性能力:如果 harness 不提供,就需要 agent 以一种更间接、更浪费 token 的方式实现的能力比如说如果 harness 不提供带通知的异步 bash 调用,agent 就会进行轮询,造成不必要的资源浪费。

本篇主要聚焦于本质能力。具体来说,是比现在的 harness 所提供的更加强大、更加难以驾驭的能力。

主动上下文管理的理念

Harness 生态如此成熟,难道真的有漏掉的本质能力吗?有的。

在绝大多数 harness 中,agent 完全无法管理自己的上下文,只能被动地不断添加,直到用户主动更换 session 或 compact,或者是触发自动 compact 为止。

我觉得这不好。现在的模型管理 subagent 的能力已经很强,那么为什么不让它管理一下它自己呢?

具体来说,我希望这种主动上下文管理实现以下几个目标:

  1. 避免浪费:结合大模型 API 的价格特征,尽量不带来额外成本
  2. 用户无感:降低用户的心智负担,理想情况下能让用户完全无视上下文窗口的存在
  3. 可持久化:上下文管理操作不应贸然永久性地删除信息

我设想的方案

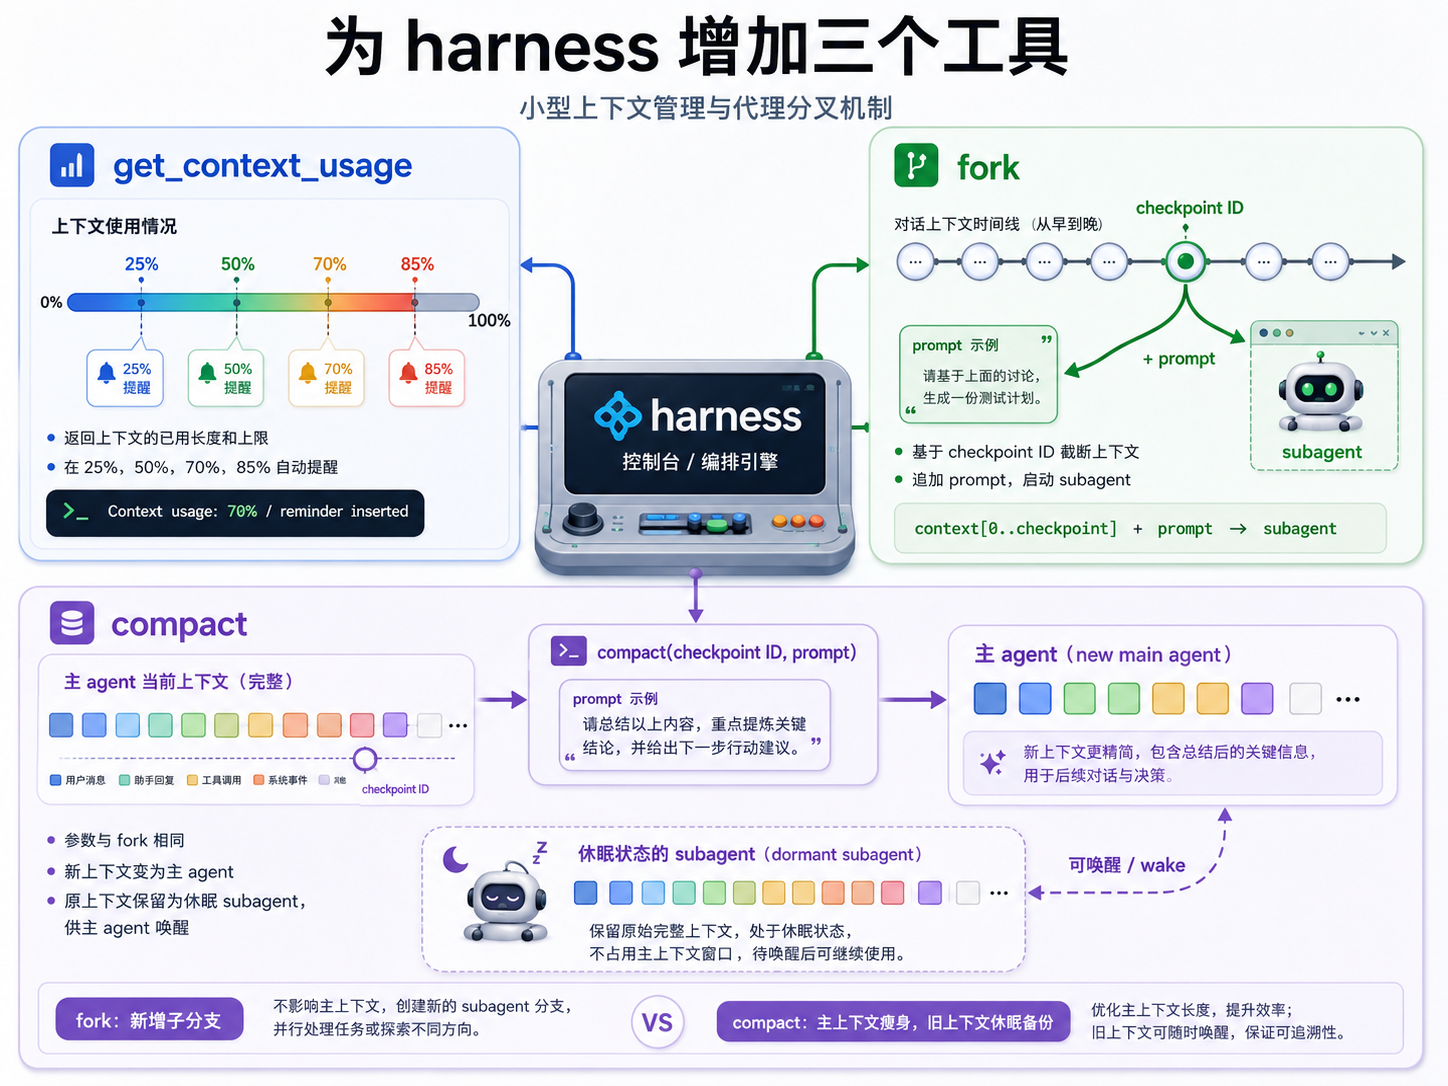
为 harness 增加三个工具:

  • get_context_usage:返回上下文的已用长度和上限;在 25%、50%、70% 和 85% 时各插入一次提醒。
  • fork:由模型给定一个 checkpoint ID 和一段 prompt,以截至该 ID 前的上下文外加这段 prompt 启动一个 subagent。
  • compact:参数与 fork 相同,但新上下文变为主 agent,原有的上下文保留为休眠状态的 subagent,供主 agent 唤醒。
图片由 GPT Image 2 生成。

出乎意料地,主动上下文管理几乎只在学术界有所研究,而没被任何主流 harness 采纳。我发现的唯一例外是 Kimi CLI 的实验性功能 SendDMail,但 Kimi CLI 已经被完全重写的 Kimi Code 取代了,这一功能也没被保留。

主动上下文管理真的多余吗?我认为不是。姑且立帖为证,相信时间会给出答案的。

或许是全网规模最大、指标最丰富的客观 Harness 评测?

评测结果见此。原始数据可以在仓库中查看。

样本选择

Harness 样本集来自 bradAGI/awesome-cli-coding-agents。这里向其作者表示真诚的感谢。

本评测限于开源的交互式终端 harness,理由如下:

  • 本评测通过阅读代码分析功能的实现情况,而这对闭源 harness 不可能
  • 非交互式 harness 通常用于 benchmark,而非日常使用
  • 不提供终端界面的 harness 通常面向非程序员群体,与本评测的视角本就不符

总共有 84 个 harness 符合上述要求,其中有 61 个达到了最高分的一半。

指标选择

指标的选择主要考虑开发者的需求,在此基础上尽量广泛。明确排除以下几项:

  • headless mode:非交互式 harness 在本评测范围之外
  • IDE、聊天软件接入:这些功能通常是 harness 的下游而非 harness 本身
  • prompt cache 友好性:难以通过阅读代码判定
  • 内置 prompt 的丰富程度:这些功能通常通过 skills 提供,本质上并非 harness 的一部分

具体指标由我和 Claude Fable 5 讨论得到,包含 9 大类(基础能力、上下文管理、后台任务、子智能体、易用性、安全、提示词套件、开发工具、模型供应商),37 小项。另有两个主观评分的大类(可扩展性、前卫特性),不计入总分。

评测流程

评测分两阶段:粗测和校准。

粗测阶段为每个样本 harness 分配一个 subagent。这个 agent 会 clone 仓库,阅读代码并给出初步报告。报告中为每小项客观指标给出 0/2/4(未实现/部分实现/完整实现)的分数,附带文字说明与代码证据。

校准阶段汇总每项指标的实际实现情况,决定 2 分和 4 分的锚点。细化规则后,为每个大类分配一个 subagent,通读所有 harness 的对应章节后重新为每个 harness 的每项指标给出 0-5 的评分。 5 分用于奖励每个指标上最优秀的 1-2 个实现。

每个大类内计算平均分,以 9 个客观大类的平均分之和作为总分。

评测由 Claude Fable 5 监工,GPT 5.6 Luna 执行。

结果

前三名分别是 oh-my-pi、qwen-code、和 codewhale。

Oh My Pi 总分最高,并且取得了最多的 5 分,唯一的明显短板是缺少沙箱机制。

Qwen Code 总分紧随其后,并且在子智能体大类中取得了惊人的满分成绩,但缺少 OAuth 支持(也就是说不能接入 Codex 等会员订阅)使其失去了相当一部分潜在用户。

CodeWhale(曾用名 DeepSeek TUI)总分第三且最为均衡,只有浏览器一个小项缺失。考虑到浏览器能力可以通过 MCP 获取,这个缺点基本可以忽略。

有趣的是,第一名和第三名都几乎是单人项目。

限用汉字,各字按现代字汇必念作第四调。为便各位看客意会,故另设括注,括注用字不受限制。下面各段俱是自作,未用智慧造物。

智慧造物(artificial intelligence)是社会的重大事业,最近的劝业计划(十五五规划)亦大量论述这项技术的各类应用。

预训练要设置巨大计算设备,并注入兆亿数据,化作代号(token)序列,智慧造物借自注意力计算预测下个代号,判定正确或错误后逆向遍溯(back propagation),变易各数,令错误率下降。另外,上述造物会辨认各地话,但并不具备视力。若欲在会话内附带照片,就要借助预训练的视嵌入器(pretrained vision embedding model),令像素块对应的向量对正造物内部各字面概念。

据霍氏大作(arXiv:2203.15556),若预训练算力二倍,验证数据上负对数概率(negative log-likelihood)会近似线性下降。这个洞见叫做放大定律(scaling law),是业界志士致力扩大智慧造物背后的重要信念。

后训练亦是必要。预训练后,智慧造物会预测下个字,但不会对话,计算较弱,更不会调用命令。训练智力项目适用下述技术:固定用户质问,令造物自撰数份复信,各计对数概率,互作对照,励正确并抑悖谬。众类似技术各具特色,暂按下不论。

近日最大变化是智慧造物会借助设备上的命令,为用户做各项任务或制作报告。造物判断现状后构造后续命令,遇到障碍会自动试错,故不必做细碎控制。这项技艺最近进步甚是迅速,对电信业益处巨大。

运用智慧造物的注意事项:造物擅杜撰,用作确切论据务必做另外验证;造物尚未具备社会义务,切莫不设护障;若用按量计费,勿意外泄露密钥。

本文纯人工撰写,无 LLM 成分。请放心阅读。

现如今,我们有大量基于层次化拆解需求的 Agent 框架,比如 Spec Kit、oh-my-openagent 的 Prometheus,以及 Kiro 的 Spec 模式等。它们通过事先调研,把一个大型需求拆解为数十甚至上百个子任务,为每个任务制定严格的完成标准,随后通过子 Agent 根据依赖关系串行或并行地执行这些任务。笔者曾大量使用 Prometheus,但逐渐发现这种方法带来的问题往往多于好处。现在我反而回到了最朴素的用法:在 plan 模式下与 LLM 讨论需求,然后直接生成。考虑到前沿 LLM 的现状,我认为各种结构化的开发模式很可能不仅带不来好处,反而阻碍了 Agent 的工作。下面我会逐一分析结构化开发模式的基本假设在当下 Agentic Coding 的实际情况中是否适用。

关于并行

在传统的软件开发中,实际编写代码需要消耗程序员大量的人力劳动,往往是一个项目中比较费时的部分。因此我们需要在这部分中安排许多人手,于是就不得不设计一套机制以恰当地协调他们的工作。一个程序员无法在可接受的时间里完成一个大型项目的开发,这是我们只能加以接受的事实。

然而在 Agent 时代,这一情况发生了改变。单个 Agent 开发代码的速度往往达到或超过了一个人深入思考并合理设计需求的速度。此外,目前前沿 LLM 的价格较为昂贵,大规模的并行 Agent 往往是个体开发者以及需要降本增效的企业所承受不起的。因此我认为,在大部分场景下,聚焦于如何让一个或少数几个 Agent 高质量地工作,比如何协调大规模 Agent 并行工作,对于通常的软件开发更加重要。

任务的粒度

这些结构化开发方法通常会在项目开始时,由一个会话深入研究用户的模糊需求,生成一份需求文档,而这份文档会在随后的开发阶段被视为几乎不可违背的金标准。早期的 LLM 实现质量很不可靠,因此需要用这样的方法时刻加以约束,防止其跑偏。

但如今的 LLM 性能已经大幅增强,并且普遍配备了 1M token 的上下文,而非此前的 200K。上下文长度对 Agent 能力的影响会随任务形式而变化:对于一个本来就能在 200K 上下文内完成的简单任务,提高上下文长度不会有任何改变;对于一个需要 100K token 的背景知识才能开展的工作,把上下文长度从 200K 提升到 1M token,意味着九倍的实际可用空间;而如果这个任务比较难,需要 300K token 的背景知识,那么 200K 上下文的模型就只能被迫在未充分理解相关信息的前提下工作。总的来说,上下文长度的增长意味着你可以向单个会话分派更多的工作,而不必强行把高度相关的一大块工作拆成两部分。因此你可以期待新一代的 LLM 可以在一个会话内完成更多的开发工作,交付更大块的成果。在这样的前提下,结构化开发方法中对任务的细粒度划分就显得过于低效了。

如果 Spec 出错

结构化开发工具的常见用途是从零开始开发一款小软件,或者在已有软件上开发一个新功能。这里涉及到的对象通常是从技术角度看比较常规的软件,其各组成部分的开发难度与最终目标是比较容易推测的。然而当 LLM 的实力逐渐增强,我们开始期待它从事一些更有挑战性的、带有一定研究性质的任务。当一个开发任务具有研究性质时,结构化开发方法很有可能会成为严重的阻碍。

我们粗略地定义一个任务的研究性为:从头开始达到最终结果所需的时间,与给定一份对最终方案的详细说明(但没有任何代码)后实现该方案所需时间的比值。一个典型的研究性强的任务是学术论文:从一个初步的想法到敲定最终方案的过程需要大量的智力劳动与实验试错,然而最终的产物可能只包含很少的代码。对于研究性强的任务,其各组件所需要满足的指标、甚至是组件划分本身,都是需要通过实验探索才能确定的。当我们把结构化开发方法应用到这种任务上时,要么得到一个欠考虑的 Spec,要么让初步研究并生成 Spec 的过程变得如此之长,以至于抵消了后续开发阶段节省的时间。实际的情况往往是前者。

当一个 Spec 设计不合理,同时又被要求强制遵守时,往往会发生很严重的后果。LLM 一向很不愿意承认自己无法达成任务,相反,它们会尽一切努力尝试绕过限制,以有违常理的方式强行宣称达到了任务目标。当大量这样的组件被组合起来时,LLM 可能直到最后的阶段才能发现,看似正常推进的项目已经千疮百孔,而这时开始补救往往困难重重,甚至只能推倒重来。这显然是我们所不愿看到的。

持续迭代

书不尽言,言不尽意。很多人抱怨 LLM 理解模糊指令的能力很差,这固然是一个可以改良的问题,但我觉得它是无法消除的。你永远无法根据几句话构建出完全符合自己心意的软件,这就需要开发者在软件构建的过程中恰当地给出反馈,引导开发过程走向自己所期望的方向。而结构化的开发方法恰恰反对这一做法,相反,它期待在编码工作开始之前,也就是需求确定阶段,就解决所有这类问题。对应到实际情况,就是期望用户认真阅读 LLM 所生成的每一行 Spec,并针对自己不满意的部分作出指示。这实在是抵消了 Agent 编程带来的很多好处,也要求用户必须有基本的技术背景以便正确审阅 Spec;而当用户缺乏此种能力,或者不愿操心直接一路通过时,就只好等待可能长达数小时的完整开发流程结束,然后在最终验收时才发现结果与自己的预期不相符合了。

如果一个任务需求模糊,那么就需要在执行过程中持续与用户同步并收集反馈;如果一个任务富于研究性,那么就需要不断地根据最新的实验结果修正整体计划。这两类问题都强调开发工作流的持续迭代能力,而这正是结构化的开发方法所不擅长的。

最佳的协作

上述讨论说明,静态的树状划分是一种低效且不能充分利用 LLM 实例的方式。我认为我们需要把更多精力投入到如何协调少数几个 Agent 之间的高效协作上,正如《人月神话》中所推荐的外科手术室团队一般。我在实践中经常使用以下两种双 Agent 工作模式,姑且称为 Reviewer 模式和 Orchestrator 模式。非常有趣的是,这两种模式恰好形成了某种形式的对偶关系。

在 Reviewer 模式中,主 Agent(也就是直接接收用户输入的 Agent)进行主要的开发工作,而当其进行到一定阶段时,便会调用一个只读的子 Agent 检查其上一阶段的工作,确保没有严重偏离原本意图,或引入了不应有的设计失误。诚然,这需要依赖主 Agent 为子 Agent 撰写提示词,不过据我观察,LLM 在大部分时候都会以诚实的态度撰写提示词,而不会暗示 Reviewer 粉饰太平。这种模式比较适合较短的任务,或者大量依赖屏幕前开发者即时反馈的任务,因为你可以在主 Agent 的界面中直接看到开发过程并加以干预。

在 Orchestrator 模式中,主 Agent 负责从全局角度理解一个任务,并将具体的开发工作分派给子 Agent,只提供很少的必要上下文以明确工作的范围。这一模式允许总体架构的存在,但同时保留了更大的弹性,允许根据某一子 Agent 给出的预期之外的结果来修改后续的整体计划。这一模式更适合需要长时间自主运行的任务。

除了 Agent 的组织方式本身,这两种模式还具有一些实用角度的优点:它天然地包含两个异构的角色,你可以很容易地为它们指派不同的模型——比如某种模型擅长编码、而另一种擅长分析,或某种模型额度充足、而另一种额度有限,这些特性都可以很好地被利用。此外,两个模型共同参与决策,也可以减轻单一模型所具有的偏见。以 Anthropic 为代表的部分公司禁止逆向其订阅服务接口并接入其他工具,而这种方法既然不需要额外的辅助设施,也可以规避掉这一问题——直接让主 Agent 通过 CLI 调用子 Agent 就好了。这种方法简单易行,且完全没有逆向接口带来的灰色地带风险。

结语

Spec 类方法的优点在于遵循软件工程的最佳实践、允许并行开发、并且具有可控的质量保证。但人类的软件工程未必适用于 LLM;前沿模型的高速度和高成本使得并行开发并非必选项;开放型任务中 Spec 提供的质量保证反而会成为对质量的伤害。因此,我认为近似串行的工作流与一到两个 Agent 的角色分工,才是最适于发挥 LLM 潜力的协作方式,并在此分享了自己的一些实践心得。

前言

看抽象代数的时候突然想到,群的 Cayley 表和数独一样,都要求每行(列)中的元素互异。那么能不能按照群的规则(即结合律)出一道变种数独题呢?于是简单试了一下。

规则:

  • 题面是一个 \(10 \times 10\) 数表(行和列从 \(0\) 开始计数),元素为 \(0 \sim 9\) 的整数;第 \(0\) 行和第 \(0\) 列的值已经给出
  • 与普通数独相同,每行、每列的元素不能重复;注意没有九宫格的条件
  • 若 \(i\) 行 \(j\) 列的值为 \(x\),\(j\) 行 \(k\) 列的值为 \(y\),则 \(i\) 行 \(y\) 列和 \(x\) 行 \(k\) 列的值相同

TLDR:补全一个以 \(0\) 为单位元的 \(10\) 阶群的乘法表。(提示:\(10\) 阶群只有 \(\mathrm{Z}_{10}\) 和 \(\mathrm{D}_{10}\) 两种)

为什么这一规则对应群

把第 \(i\) 行第 \(j\) 列的值记为 \(i \otimes j\). 根据第一条规则,\(\otimes\) 是 \(\{0,1,\dots,9\}\) 上的一个二元运算,值域也是 \(\{0,1,\dots,9\}\). 因此 \(\otimes\) 满足封闭性。

第 \(0\) 行和第 \(0\) 列的值表明,对任意 \(x\) 都有 \(0 \otimes x = x \otimes 0 = x\),因此 \(0\) 是单位元。

若 \(i \otimes j = x,\ j \otimes k = y\),由第三条规则可得

\[ i \otimes (j \otimes k) = i \otimes y = x \otimes k = (i \otimes j) \otimes k, \]

因此 \(\otimes\) 满足结合律。

根据第二条规则,每一行、每一列的 \(10\) 个数都互不相同;又因为它们都落在 \(\{0,1,\dots,9\}\) 中,因此每一行、每一列都是这 \(10\) 个数的一个排列。

于是对任意 \(a\),存在 \(b,c\) 使得 \(a \otimes b = 0,\ c \otimes a = 0\). 再由结合律可得

\[ c = c \otimes 0 = c \otimes (a \otimes b) = (c \otimes a) \otimes b = 0 \otimes b = b, \]

因此 \(b\) 同时是 \(a\) 的左逆元和右逆元。

综上所述,这三条规则恰好定义了一个以 \(0\) 为单位元的 \(10\) 阶群;反过来,任何 \(10\) 阶群的 Cayley 表也都满足这三条规则。

题目

题 1:(表中横、竖线仅作美化排版用途,无实际含义)

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & 0 & & & & & & & & \\ 2 & & & 1 & & & & & & \\ 3 & & 4 & & & & & & & \\ \hline 4 & & & & & & & & & \\ 5 & & & & 2 & & & & & \\ 6 & & & & & & & & & \\ \hline 7 & & & & & & 3 & & & \\ 8 & & & & & 9 & & & & \\ 9 & & & & & & & & & \\ \end{array} \]

解析

表中 \(2 \otimes 3 \ne 3 \otimes 2\),说明这个群一定是 \(\mathrm{D}_{10}\). 这里先明确一下记号:\(\mathrm{D}_{10} = \langle r, s \mid r^5 = s^2 = e,\ sr = r^{-1}s \rangle\).

解决题目的关键在于理解 \(\mathrm{D}_{10}\) 的自同构。 \(\operatorname{Aut}(\mathrm{D}_{10})\) 在 \(\{r,r^2,r^3,r^4\}\) 与 \(\{s,rs,r^2s,r^3s,r^4s\}\) 上分别传递作用;等价地,任取一个非单位旋转元 \(r^n\ (n=1,2,3,4)\) 和一个反射元 \(r^m s\ (m=0,1,2,3,4)\),都存在 \(\mathrm{D}_{10}\) 的自同构 \(\varphi\),使得 \(\varphi(r^n)=r,\ \varphi(r^m s)=s\).

\(0\) 是单位元,而 \(1 \otimes 1 = 0\),说明 \(1\) 是“s 型”元素。再由上面的自同构性质可知,若本题有解,则一定可以通过适当的自同构让 \(1\) 对应群中元素 \(s\)(下文简写为 \(1 \sim s\))。因此不妨设 \(1 \sim s\).

\(2 \otimes 3 = 1\),说明 \(2\) 和 \(3\) 一个是“r 型”,一个是“s 型”。注意到 \(5 \otimes (3 \otimes 2) = 2\),因此 \(5\) 和 \(3\) 互为逆元。“s 型”元素的逆元都是它本身,因此 \(3\) 是“r 型”,\(2\) 是“s 型”。

不妨设 \(3 \sim r\),则 \(2 \sim rs\),\(5 \sim r^4\). \(3 \otimes 2 = 4\),说明 \(4 \sim r^2 s\).

这是目前已确定的元素:

\(0\)\(1\)\(2\)\(3\)\(4\)\(5\)\(6\)\(7\)\(8\)\(9\)
\(e\)\(s\)\(rs\)\(r\)\(r^2 s\)\(r^4\)

还剩下 \(r^2,\, r^3,\, r^3 s,\, r^4s\) 尚未确定。

\(7 \otimes 6 = 3\),说明 \(6\) 和 \(7\) 要么都是“r 型”,要么都是“s 型”。而 \(r^2 \cdot r^3 = r^3 \cdot r^2 = e\),说明 \(6\) 和 \(7\) 只能都是“s 型”,因此 \(6 \sim r^3 s\),\(7 \sim r^4 s\).

\(8 \otimes 5 = 9\),而 \(8\) 和 \(9\) 只能在 \(r^2,\, r^3\) 中取值,因此 \(8 \sim r^3\),\(9 \sim r^2\).

完整的对应关系如下:

\(0\)\(1\)\(2\)\(3\)\(4\)\(5\)\(6\)\(7\)\(8\)\(9\)
\(e\)\(s\)\(rs\)\(r\)\(r^2 s\)\(r^4\)\(r^3 s\)\(r^4 s\)\(r^3\)\(r^2\)

据此把乘法表补全即可。

答案:

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & 0 & 5 & 7 & 8 & 2 & 9 & 3 & 4 & 6 \\ 2 & 3 & 0 & 1 & 5 & 4 & 8 & 9 & 6 & 7 \\ 3 & 2 & 4 & 9 & 6 & 0 & 7 & 1 & 5 & 8 \\ \hline 4 & 9 & 3 & 2 & 0 & 6 & 5 & 8 & 7 & 1 \\ 5 & 7 & 1 & 0 & 2 & 8 & 4 & 6 & 9 & 3 \\ 6 & 8 & 9 & 4 & 3 & 7 & 0 & 5 & 1 & 2 \\ \hline 7 & 5 & 8 & 6 & 9 & 1 & 3 & 0 & 2 & 4 \\ 8 & 6 & 7 & 5 & 1 & 9 & 2 & 4 & 3 & 0 \\ 9 & 4 & 6 & 8 & 7 & 3 & 1 & 2 & 0 & 5 \\ \end{array} \]

题 2:

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & & & & & & & & & \\ 2 & & & & & & & & & \\ 3 & & & 0 & & & & & & 4 \\ \hline 4 & & & & & & & & 0 & \\ 5 & & 7 & & & & & & & \\ 6 & & & & & & & & & \\ \hline 7 & & & & & & & & & \\ 8 & & & & & 2 & & & & \\ 9 & & & & 1 & & & & & \\ \end{array} \]

解析

用和题 1 类似的方法,可以发现 \(\mathrm{D}_{10}\) 是不行的。因此,这个群只能是 \(\mathrm{Z}_{10}\). 记 \(\mathrm{Z}_{10} = \langle g \mid g^{10} = e \rangle\).

\(3 \otimes 3 = 0\),说明 \(3\) 的阶为 \(2\),因此 \(3 \sim g^5\).

考虑从 \(4\) 出发往后推。但我们还不确定 \(4\) 的阶是 \(5\) 还是 \(10\). 先假设 \(4\) 的阶是 \(5\),那么不妨设 \(4 \sim g^2\).

\(3 \otimes 9 = 4\),说明 \(9 \sim g^7\). \(4 \otimes 8 = 0\),说明 \(8 \sim g^8\). \(9 \otimes 4 = 1\),说明 \(1 \sim g^9\).

这是目前已确定的元素:

\(0\)\(1\)\(2\)\(3\)\(4\)\(5\)\(6\)\(7\)\(8\)\(9\)
\(e\)\(g^9\)\(g^5\)\(g^2\)\(g^8\)\(g^7\)

还剩下 \(g,\, g^3,\, g^4,\, g^6\) 尚未确定。

还有两个条件没有用到:\(5 \otimes 2 = 7\) 和 \(8 \otimes 5 = 2\). 对 \(8 \otimes 5 \otimes 2\) 使用结合律,得到 \(2 \otimes 2 = 8 \otimes 7\).

这说明 \(7\) 是 \(g^4\) 或者 \(g^6\). 若 \(7 \sim g^4\),则 \(2 \sim g\) 或 \(2 \sim g^6\);若 \(7 \sim g^6\),则 \(2 \sim g^2\) 或 \(2 \sim g^7\),矛盾。因此,\(7 \sim g^4\).

\(5 \otimes 2 = 7\),若 \(2 \sim g\),则 \(5 \sim g^3\);若 \(2 \sim g^6\),则 \(5 \sim g^8\),矛盾。因此,\(2 \sim g\),\(5 \sim g^3\),\(6 \sim g^6\).

完整的对应关系如下:

\(0\)\(1\)\(2\)\(3\)\(4\)\(5\)\(6\)\(7\)\(8\)\(9\)
\(e\)\(g^9\)\(g\)\(g^5\)\(g^2\)\(g^3\)\(g^6\)\(g^4\)\(g^8\)\(g^7\)

据此把乘法表补全即可。

如果 \(4\) 的阶是 \(10\),按同样流程推导会出现矛盾,过程不再赘述。

答案:

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & 8 & 0 & 7 & 2 & 4 & 3 & 5 & 9 & 6 \\ 2 & 0 & 4 & 6 & 5 & 7 & 9 & 3 & 1 & 8 \\ 3 & 7 & 6 & 0 & 9 & 8 & 2 & 1 & 5 & 4 \\ \hline 4 & 2 & 5 & 9 & 7 & 3 & 8 & 6 & 0 & 1 \\ 5 & 4 & 7 & 8 & 3 & 6 & 1 & 9 & 2 & 0 \\ 6 & 3 & 9 & 2 & 8 & 1 & 4 & 0 & 7 & 5 \\ \hline 7 & 5 & 3 & 1 & 6 & 9 & 0 & 8 & 4 & 2 \\ 8 & 9 & 1 & 5 & 0 & 2 & 7 & 4 & 6 & 3 \\ 9 & 6 & 8 & 4 & 1 & 0 & 5 & 2 & 3 & 7 \\ \end{array} \]


以下是作者的一些疑问:

  1. 存不存在只有 5 个已知数且有唯一解的题面?
  2. 有没有比较有效的方法构造这类题目的 \(8 \times 8\) 版本?

自动生成器

时隔一年多突然想起这篇烂尾博客,我惊喜地发现现在的 LLM 已经可以爆杀上文的两个疑问了。以下两节的代码全部由 GPT-5.4 生成。

首先从枚举所有合法的 Cayley 表开始。借助一些(我并不会的)抽象代数知识,可以在近似 \(O(\mathrm{output \_ size})\) 的时间复杂度内完成枚举。生成枚举结果的 GAP 程序见此。生成 3GiB 大小的 \(12 \times 12\) Cayley 表全集需要约 5min。

\(8\) 阶群有 \(2760\) 种 Cayley 表,\(10\) 阶群有 \(108864\) 种,\(12\) 阶群有 \(21621600\) 种。对于 \(8\) 阶和 \(10\) 阶群,可以直接使用(剪枝后的)暴力搜索找出已知数最少且有唯一解的题面。对于 \(12\) 阶群,暴力搜索已经不可行了,因此略作妥协:对于每类群,随机选择一个答案,二分搜索已知数的数量,随机生成题面,若连续 \(1000\) 个题面都有多解,则认为该数量的已知数不足以保证唯一解,尝试更多的已知数。

对于两种 \(10\) 阶群,最少的已知数都是 \(5\) 个:

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & 5 & & & & & & & & \\ 2 & & 4 & & & & & & & \\ 3 & & & & 8 & & & & & \\ \hline 4 & & & & & & & & & \\ 5 & & 7 & & & & & & & \\ 6 & 3 & & & & & & & & \\ \hline 7 & & & & & & & & & \\ 8 & & & & & & & & & \\ 9 & & & & & & & & & \\ \end{array} \]

\[ \begin{array} {r|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 \\ \hline 1 & 7 & & & & & & & & \\ 2 & & 8 & & & & & & & \\ 3 & 6 & & & & & & & & \\ \hline 4 & & & & & 8 & & & & \\ 5 & & & & & & 2 & & & \\ 6 & & & & & & & & & \\ \hline 7 & & & & & & & & & \\ 8 & & & & & & & & & \\ 9 & & & & & & & & & \\ \end{array} \]

8 阶群的结果

这些题目都不难,欢迎读者尝试!为减少对读者时间的浪费,我直接给出了每道题对应的群类型。

\(\mathrm{Z}_8\):

\[ \begin{array} {rrrr|rrrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ 1 & & & & & & & \\ 2 & 3 & & & & & 5 & \\ 3 & & & & & & & 4 \\ \hline 4 & & & & & & & \\ 5 & & & & & 3 & & \\ 6 & & & & & & & \\ 7 & & & & & & & \\ \end{array} \]

\(\mathrm{Z}_4 \times \mathrm{Z}_2\):

\[ \begin{array} {rrrr|rrrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ 1 & 0 & & & & & & \\ 2 & & & & & & & 0 \\ 3 & & & & & & & \\ \hline 4 & & & & 3 & & & \\ 5 & & & & & & & \\ 6 & & & & 2 & & & \\ 7 & & & & & & & \\ \end{array} \]

\(\mathrm{D}_8\):

\[ \begin{array} {rrrr|rrrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ 1 & & & & & & & \\ 2 & & & & & & & \\ 3 & & & & & & & \\ \hline 4 & & & & & & & \\ 5 & & & & & 0 & & \\ 6 & & & & & & 3 & 2 \\ 7 & 3 & & & & & & \\ \end{array} \]

\(\mathrm{Q}_8\):

\[ \begin{array} {rrrr|rrrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ 1 & & & & & & & \\ 2 & & & 5 & & & & \\ 3 & & & & & & & \\ \hline 4 & & & & 7 & 6 & & \\ 5 & & & & & 7 & & \\ 6 & & & & & & & \\ 7 & & & & & & & \\ \end{array} \]

\(\mathrm{Z}_2 \times \mathrm{Z}_2 \times \mathrm{Z}_2\):

\[ \begin{array} {rrrr|rrrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 \\ 1 & & & & & & 4 & \\ 2 & & & & & 1 & & \\ 3 & & & & 2 & & & \\ \hline 4 & & & & & & & \\ 5 & & & 6 & & & & \\ 6 & 4 & & & & & & \\ 7 & & & & & & & 0 \\ \end{array} \]

12 阶群的结果

我对这些群不熟悉,就不手算了,总之能做

\(\mathrm{Q}_{12}\):

\[ \begin{array} {rrr|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & \mathrm{A} & \mathrm{B} \\ 1 & & 4 & & & & & & & & & \\ 2 & & & & & & & & & & & \\ \hline 3 & & & & & & & \mathrm{B} & & & & \\ 4 & & & & & & & & & & & \\ 5 & & & & & & & 1 & & & & \\ \hline 6 & & & & & & & & & & & \\ 7 & & & 6 & & & 8 & & & & & \\ 8 & & & & & & & & & & & \\ \hline 9 & & & 1 & & & & & & & & \\ \mathrm{A} & & & & & & & & & & & \\ \mathrm{B} & & & & & & & & & & & \\ \end{array} \]

\(\mathrm{Z}_{12}\):

\[ \begin{array} {rrr|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & \mathrm{A} & \mathrm{B} \\ 1 & & & & & & & & & & & \\ 2 & & & & & 6 & & & & & & \\ \hline 3 & & & & & & & & & & & \\ 4 & & & & & & & & & & \mathrm{B} & \\ 5 & & & & & & & & & & & \\ \hline 6 & & & & & & & & & 2 & & \\ 7 & & & & & & & & & & & \\ 8 & & & & & & & & 2 & & & \\ \hline 9 & & & & & & & & & & & \\ \mathrm{A} & 0 & & & & & & & & & 5 & 7 \\ \mathrm{B} & & & & & & & & & & & \\ \end{array} \]

\(\mathrm{A}_{4}\):

\[ \begin{array} {rrr|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & \mathrm{A} & \mathrm{B} \\ 1 & & & & & & & & & & & \\ 2 & & & \mathrm{B} & & & & & & & & \\ \hline 3 & & & & & & & & & & & \\ 4 & & & & & & & & & & & \\ 5 & 7 & & & & & & & & & & \\ \hline 6 & & & & & 7 & & & & & & \\ 7 & & & & & & & & & & & \\ 8 & & & & & & & & 5 & & & \\ \hline 9 & & & & & 4 & & & & & & \\ \mathrm{A} & & & & & & & & & & & \\ \mathrm{B} & & & & & & & & & & & \mathrm{A} \\ \end{array} \]

\(\mathrm{D}_{12}\):

\[ \begin{array} {rrr|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & \mathrm{A} & \mathrm{B} \\ 1 & & & & & & & & & & & \\ 2 & & & & & & & & & & & \\ \hline 3 & & & & & & & & & & & \\ 4 & & & & & & 9 & & & & & \\ 5 & & & & & & & & & & & \\ \hline 6 & & 1 & & & & & & & & & \\ 7 & & & & & 8 & & & & & & \\ 8 & 4 & & & & & & & & & & \\ \hline 9 & \mathrm{A} & & & & & & & & & & \\ \mathrm{A} & & & & 3 & & & & & & & \\ \mathrm{B} & & & & & & 0 & & & & & \\ \end{array} \]

\(\mathrm{Z}_{6} \times \mathrm{Z}_{2}\):

\[ \begin{array} {rrr|rrr|rrr|rrr} 0 & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & \mathrm{A} & \mathrm{B} \\ 1 & & & & & & 3 & & & & & \\ 2 & & & & & & & & & & & \\ \hline 3 & & & & & & & & & & & \\ 4 & & & & & & & & & & & \\ 5 & & & & & & & & & & & \\ \hline 6 & & 8 & & & & & & & & & \\ 7 & & & & & & & & & & & \\ 8 & 4 & & & & & & & & & & \\ \hline 9 & & & & & & & & & & & \\ \mathrm{A} & & & & & & & 9 & & 8 & & \\ \mathrm{B} & & & & 3 & & & 2 & & & & \\ \end{array} \]

自动求解器

首先考虑最暴力的求解方法:直接把结合律作为约束,使用求解器求解。使用 Z3 描述这种约束非常简单:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
op = Function("op", IntSort(), IntSort(), IntSort())
solver = Solver()

for left in range(order):
for right in range(order):
solver.add(op(left, right) >= 0, op(left, right) < order)

for element in range(order):
solver.add(op(0, element) == element)
solver.add(op(element, 0) == element)
solver.add(Distinct([op(element, other) for other in range(order)]))
solver.add(Distinct([op(other, element) for other in range(order)]))

for row in range(1, order):
for col in range(1, order):
clue = grid[row][col]
if clue is not None:
solver.add(op(row, col) == clue)

for a in range(order):
for b in range(order):
for c in range(order):
solver.add(op(a, op(b, c)) == op(op(a, b), c))

这个程序可以求解 \(8\) 阶和 \(10\) 阶的题目,但对于 \(12\) 阶的题目就无能为力了:五道题目在 1min 的时限内都无法求解并证明唯一性。

能不能做得更好呢?答案是肯定的。我们可以把抽象代数知识融入求解器,告诉它对应阶数的群的所有种类。对于每个种类,任取一个 Cayley 表作为规范形,让求解器搜索题面数字与这一 Cayley 表中元素之间的一一映射。这样,求解器的搜索空间就从 \(121\) 个格子变成了 \(11\) 个元素的排列。改进后的程序可以在 27s 内解决五道 \(12\) 阶题目。

当然——如果融入更多的知识,也就是直接把所有 Cayley 表丢进去,那么遍历一遍就能得到答案了,用时甚至不到一秒钟!看来数学理论对这个奇特的解谜帮助确实很大(笑)

TLDR: 使用 Pandas 读取 CSV 文件时,最好指定 keep_default_na=False, na_values=''。

问题

Pandas 的 read_csv 默认会把长得像无效值的字符串(如 NA、null、None 等)解析为 NaN,而这些字符串有时确实是合法内容(比如某些不知好歹的人的用户名)。这会导致读入 CSV 后重新导出的过程中丢失数据。

Pandas 默认的 NA 值列表可以在文档中找到:

By default the following values are interpreted as NaN: , #N/A, #N/A N/A, #NA, -1.#IND, -1.#QNAN, -NaN, -nan, 1.#IND, 1.#QNAN, <NA>, N/A, NA, NULL, NaN, None, n/a, nan, null.

解决方案

在 read_csv 时指定以下参数:

1
2
df = pd.read_csv('data.csv', keep_default_na=False, na_values='')
df.to_csv(index=False)

keep_default_na=False 的作用是禁用默认的 NA 值列表;na_values='' 的作用是把空字符串视为缺失值。如果去掉后者,则所有包含空单元格的列都会被视作字符串类型,对数值类数据不合理。

美中不足的是,并不存在一个参数可以直接将所有字符串列的空值视作 '',同时保留数值列的 NaN。不过可以通过后续处理来实现:

1
2
cols = df.select_dtypes(include=['object']).columns
df.fillna(pd.Series('', index=cols), inplace=True)

示例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
>>> df = pd.read_csv(io.StringIO('str,num\nnull,\n,1')); df
str num
0 NaN NaN
1 NaN 1.0

>>> df = pd.read_csv(io.StringIO('str,num\nnull,\n,1'), keep_default_na=False, na_values=''); df
str num
0 null NaN
1 NaN 1.0

>>> df.fillna(pd.Series('', index=df.select_dtypes(include=['object']).columns))
str num
0 null NaN
1 1.0

自然出怪的特点

在之前我们写的脚本中,绝大多数都假设每一波的刷新时长是一个定值。这使得脚本执行的操作与场上状态基本无关,大幅简化了脚本的编写。

但是,当我们把目光转向自然出怪长生存时,我们会面临很多新的问题:

  • 两炮激活可能会刷新延迟
  • 双边热过渡可能会意外刷新
  • 红眼关随时可能转白
  • 收尾的不确定性很大

即便是对于打法非常固定的键控炮阵,这些问题通常也是难以避免的。我们接下来逐个分析这些问题。

刷新延迟和意外刷新在实现上是可以统一的:它们通常的处理方法都是在某个时间点检查是否刷新,视结果执行不同的分支。

在转白之后,我们通常希望改用白眼/快速关的打法以节省资源。转换阵解时可能需要几个过渡波处理残留的红眼。

收尾很难有统一的应对方案,需要视所守列数和炮恢复情况而定。

状态机对前三个问题提供了一种较为泛用的解决方案。它保留了常规逐波/循环定态脚本的易写易读的优点,但同时又有一定的表达能力,足以应对自然出怪冲关的复杂条件。

状态机

在状态机的框架下,阵解由许多个状态组成,状态之间相互连接。每个状态代表一波或其一部分。

状态之间以刷新节点为边界。什么是刷新节点呢?比如你炸了一对激活炮,这时可能激活,也可能没有激活,炮落地的瞬间就是一个刷新节点。

如果阵型里有前场自然输出,有可能你不需要做什么也会自动刷新。这种情况下,刷新节点是连续的。状态转移允许指定一个时间区间,在区间内任意时间激活视作正常激活,区间结束时仍未激活视作延迟。

在刷新节点观测到的场上信息会用来决定转移路径。如果把阵解建模成一张图,那么状态是节点,转移路径就是连接两者的有向边。比如说你执行一组操作(它们被封装在一个状态中),执行之后可能延迟,也可能激活刷新,就需要为它配置两条转移路径。如果你确信某操作不会出现刷新意外,就可以只配置一条转移路径。

每个转移路径都有触发条件。现实中,在根据刷新情况进行状态转移时,我们一般只会使用固定的几种条件。作者实现的转移函数支持以下几种条件:

  • 延迟
  • 激活,下波为指定波次(如w9/w19)
  • 激活,下波转白
  • 激活,无特殊情况

状态机的优势在于,如果脚本只使用这几种转移条件,则完全不需要自行编写判断刷新的代码,具体的判断逻辑交由预定义的转移函数处理。

本文接下来以一个经典超多炮阵型——双冰16炮为例,介绍状态机框架下代码的编写。

代码架构

状态机的核心是以下几个变量和函数:

1
2
3
4
5
6
7
8
9
unordered_map<string, ATimeline> states;
string lastState, currentState;

_TransitionKey activate, delay, nogiga, finish;
_TransitionKey WaveIs(std::convertible_to<int> auto... waves);

ATimeline Transition(pair<int, int> wl, auto... args);
ATimeline Transition(int wl, auto... args);
void StartTransition(int wave, const string& state);

Transition函数封装了状态转移的所有逻辑,其调用格式形如Transition(601, key1 = "next_state_name1", key2 = "next_state_name2", ...) (如果你对这种语法感到不解:在C++中,operator=可以被重载,并且返回类型可以任意指定)。其中的key可以是delay、activate、nogiga和finish,对应上一节中提到的四种转移条件(finish等效于WaveIs(9, 19))。

lastState和currentState是由Transition函数自动设置的,在运阵过程中可以读取。

states用于存储阵解,键代表状态名(可以任意取),值代表该状态对应的操作。在AScript()中,操作被逐个添加到states中,形如:

1
2
3
4
states["s1"] = {
Transition(601, activate = "s2", delay = "s3"),
At(300) PP(),
};

这段代码表示若当前状态为s1,则在本波300时刻发一对炮,若401时刻激活,则在下波执行状态s2;若401时刻未激活,则在本波执行状态s3。

状态机一般需要在w1和w10各启动一次(w20不需要纳入状态机中)。启动状态机的代码是:

1
2
StartTransition(1, "state1");
StartTransition(10, "state2");

一个完整的状态机脚本的大致结构是:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 状态机本身的代码

void AScript() {
// 选卡等等操作

states["s1"] = {
Transition(601, activate = "s2", delay = "s3", finish = "final1"),
// ...
};
states["s2"] = {
Transition(1200, activate = "s1", delay = "s4", finish = "final2"),
// ...
};
// ...

StartTransition(1, "s1");
StartTransition(10, "s1");
OnWave(20) {
// ...
};
}

阵解分析

主循环

本教程侧重于键控脚本编写,对阵解设计部分只是简略带过。如果对本节理解有困难可以跳过。

我们采用经典的ch6解:IPP-PP|PPDD循环。运阵过程中有两处可能发生刷新意外:

  • IPP刷新
  • IPP-PP延迟

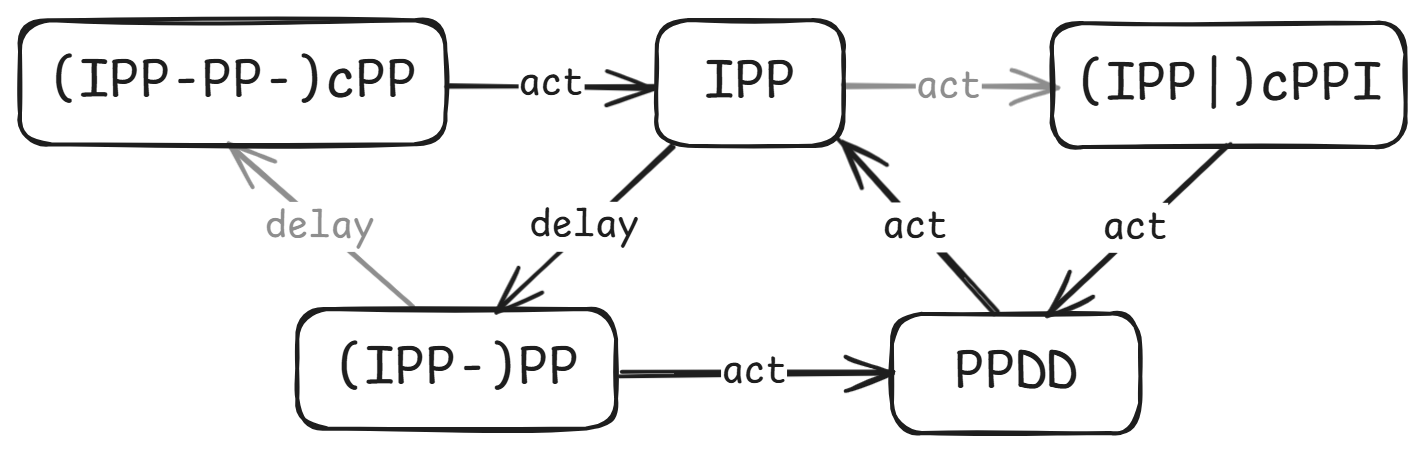
对于前一种情况,我们可以把冰波改成IPP|cPP。第二波的PP要同时全伤两波的红眼,设冰波1冰1048激活,加速波389激活(垫舞王激活的最晚时机),得出IPP波波长应为1048-389=659,对应459热过渡。加速波的红眼再冰一下,避免砸炮。

对于后一种情况,我们可以在激活炮之后再补一对炮,然后直接接下一个冰波。在执行IPP-PP|PPDD时,加速波的PP发射时本波僵尸还未刷出。本着能不读刷新倒计时就不读的态度,不妨让这对炮无论冰波是否延迟都照常发射。这样的话,冰波延迟时的激活时机为1248+291=1539。(注:由于引信延迟,实际激活时机也可能是1542。引信延迟并不会给此阵造成任何实质上的困难,但会给脚本编写增加无谓的工作量,因此脚本中关闭了引信延迟)

把状态转移关系画成图,是这样的:

主循环状态转移图

代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
// 冰波:IPP-PP 1248
states["hb_IPP"] = {
Transition(659, delay = "hb_(IPP-)PP", activate = "hb_(IPP|)cPPI"),
At(1) I(),
At(459) P(15, 8.325),
At(1048) PP(8.75), // 1048 = 659 + 389
};
states["hb_(IPP-)PP"] = {
Transition(1248, activate = "hb_PPDD", delay = "hb_(IPP-PP-)cPP"),
};
// 加速波:PPDD 601
states["hb_PPDD"] = {
Transition(601, activate = "hb_IPP"),
At(291) PP() & DD<107>(9),
};
// 冰波延迟:IPP-PP-cPP 1739
states["hb_(IPP-PP-)cPP"] = {
Transition(1739, activate = "hb_IPP"),
At(1300) C.TriggerBy(AGIGA_GARGANTUAR & CURR_WAVE)(266),
At(1539) PP(), // 1539 = 1248 + 291
};
// 冰波意外刷新:IPP|cPPI 659|601
states["hb_(IPP|)cPPI"] = {
Transition(601, activate = "hb_PPDD"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
At(390) I(),
};

细心的读者可能会问:hb_(IPP|)cPPI一定不会延迟吗?事实上热过渡意外刷新和PP延迟对出怪的要求是一定程度上相互冲突的,前一波意外刷新而后一波延迟的概率极低,可以忽略。当然把这一部分补上也是不难的,具体实现就留给读者了。

首代

为了省冰,我们在w1和w10用NDD首代一波。虽然红眼关w10 PPDD不太可能延迟,但保险起见写上好了。脚本很简单,就不细讲了:

1
2
3
4
5
6
7
8
9
10
// 红眼关起手:NDD 601
states["hb_NDD"] = {
Transition(601, activate = "hb_PPDD", delay = "hb_(NDD-)PP"),
At(292) N({{3, 9}, {4, 9}}) & DD<106>(9),
};
// NDD延迟:NDD-PP 1092
states["hb_(NDD-)PP"] = {
Transition(1092, activate = "hb_IPP"),
At(892) PP(), // 892 = 601 + 291
};

收尾

到目前为止,我们顺利解决了w1~w8,下一个任务是w9/w19。需要注意的是,w9/w19的激活判定只考虑本波僵尸,因此可能出现w9激活后w8红眼仍在场上的情况。

收尾的处理方式需要视阵型特点而定。此阵炮数充足,收尾容错很大。ch6冰循环压力本就不大,加之此阵转白后无需用冰,不需要拖w9/w19的收尾。因此这里采用了一种比较朴素的处理方式。

首先是w9本波的激活操作。既然已经到了收尾波,没有热过渡的必要,可以直接把IPP改成PPI(由于主循环时长3700>3475,这里是能复用上的)。加速波反正早晚得冰,不如也改成PPI。唯一的例外是上波为IPP,此时本波仍需cPPI以保证全伤上波红眼。

极端条件下,可能会出现w9 401激活(对应波长1346),而场上仍有w8三血红的情况。这时虽然剩余的炮不够把它们炸死,但我们可以把这些w8红眼拖到w10。假设w9 401激活,根据w8的类型分类讨论:

  • IPP:剩3血红和w8撑杆,猴年马月才能砸炮。一炮收掉残余的撑杆,剩下的2血红交给w10
  • (IPP-)PP或(IPP|)cPPI:剩2血红,1510砸炮。垫一下,交给w10收掉
  • PPDD或(IPP-PP-)cPP:剩1血红,1161砸炮。一对炮收掉

如果w9 401没有激活,假设收尾使用8门炮,算一下可能的复用:

  • IPP-PP|[PP]DD|收尾|NDD|PP[DD]:收尾最短时间3475+291−601×2−398=2166,对应1221激活
  • PPDD|I[PP]-PP|收尾|NDD|PP[DD]:收尾最短时间3475+459−1248−601−398=1687,对应742激活
  • PPDD|IPP-[PP]-PP|收尾|NDD|PP[DD]:收尾最短时间3475+1048−1739−601−398=1785,对应840激活
  • [PP]DD|IPP|收尾|NDD|[PP]DD:收尾最短时间3475+291−601×2−659−291=1614,对应669激活

可以看出除了第一种情况都是白给。第一种情况下,为了收掉w8的红眼,需要早于1161炸一对炮。但如果这对炮导致激活,说明w8和w9的僵尸一定都死了,不需要再炸剩下两对炮。这样复用就能宽松很多,依然不会出问题。

作为演示脚本,就不拖收尾了,直接炸掉就好。预定在1000、1500和2300发炮,如果此时已经进入w10或不存在除伴舞和小鬼之外的僵尸则取消此次发炮。

作者编写了一个简单的EndingHelper函数用于处理这种较简单的收尾。这个函数的原型是:

1
2
3
4
ATimeline EndingHelper(const vector<int>& times, const vector<ATimeline>& ops,
int withdrawThreshold = 0);
ATimeline EndingHelper(const vector<int>& times, const ATimeline& op,
int withdrawThreshold = 0);

它的功能是在当前波(EndingHelper执行时的波次)的times[0]时间执行ops[0],times[1]时间执行ops[1],以此类推(若ops中只有一个操作,则每次都执行ops[0])。如果场上没有僵尸(无视小鬼、伴舞,开启女仆时额外无视舞王),或者当前操作对应的时间已经超过了下一波的withdrawThreshold,则取消操作。

比如OnWave(19) EndingHelper({1200, 1800, 2400}, PP(), 0); 的含义为在w19的1200cs、1800cs和2400cs各生效一对炮,保证炮的生效时间不会在w20的0cs之后。若1200cs的炮激活了刷新,则w19的波长为2145cs,这时1800cs的炮会照常发射,但2400cs的炮会被取消。

收尾代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
states["hb_final"] = At(-200) CoDo {
// 发本波的激活炮
ATime thisWave = now + 200;
if (lastState == "hb_IPP") {
// cPPI波的处理和其他波不同
At(thisWave + 195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40);
At(thisWave + 390) I();
} else {
At(thisWave + 291) PP();
At(thisWave + 360) I();
}

co_await (thisWave + 401);
if (ANowTime(true).time < 0) {
// 如果收尾波直接刷了(波长1346)
if (lastState == "hb_IPP") {
// w8红还剩3血,w8撑杆还在;一炮收掉撑杆,红眼交给w10
At(thisWave + 900) PP();
} else if (lastState == "hb_(IPP-)PP" || lastState == "trans_cPP") {
// w8红还剩2血,1510砸炮;垫一下红眼就行
At(thisWave + 401) C.TriggerBy(AGIGA_GARGANTUAR)(800);
} else if (lastState == "hb_PPDD" || lastState == "hb_(IPP-PP-)cPP") {
// w8红还剩1血,最快1161砸炮;用炮收掉
At(thisWave + 1161) PP();
}
} else {
// 随便炸炸
At(now) EndingHelper({1000, 1500, 2300}, PP());
}
};

代码中通过读取lastState实现了对w8的分类讨论。

收尾段还有一个额外的小问题:如果w8轮到(IPP|)cPPI状态,咖啡豆CD会不够。此时需要特化处理一下这一波,去掉w8的冰,改打cPP|PPIc。为此,需要给IPP状态添加一个WaveIs(8, 18)分支:

1
2
3
4
5
6
7
8
9
10
11
12
13
// 冰波:IPP-PP 1248
states["hb_IPP"] = {
Transition(659, delay = "hb_(IPP-)PP", activate = "hb_(IPP|)cPPI", WaveIs(8, 18) = "hb_(IPP|)cPPI_w8", finish = "hb_final"),
At(1) I(),
At(459) P(15, 8.325),
At(1048) PP(8.75), // 1048 = 659 + 389
};
// 如果cPPI波出现在w8,需要调整为cPP|PPIc
states["hb_(IPP|)cPPI_w8"] = {
Transition(601, finish = "hb_final"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
At(next_wave + 401) C.TriggerBy(AGIGA_GARGANTUAR)(800),
};

转白

转白是大部分键控自然出怪阵型都需要考虑的事项。一方面,转白后通常可以省冰、省阳光;另一方面,转白后热过渡意外刷新的概率会明显上升。

首先考虑这个阵的白眼关阵解。打P6的话,每3波有一对多余的炮,因此可以垫两波PPDD一波,就不需要冰了。写成轨道是cPP|PPc|PPDD。

这一部分比红眼关简单得多,就不细讲了,直接上代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
states["b_PPDD"] = {
Transition(601, activate = "b_cPP", delay = "b_(PPDD)-PP", finish = "b_final"),
At(270) PP() & DD<110>(9),
};
states["b_(PPDD)-PP"] = {
Transition(1202, activate = "b_PPc", finish = "b_final"),
At(1002) PP(),
};
states["b_cPP"] = {
Transition(601, activate = "b_PPc", finish = "b_final"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
At(389) PP(8.75),
};
states["b_PPc"] = {
Transition(601, activate = "b_PPDD", finish = "b_final"),
At(318) PP(),
At(599) C.TriggerBy(APOLE_VAULTING_ZOMBIE)(1),
};
states["b_final"] = At(-200) Do {
ATime thisWave = now + 200;
if (GetCobReadyTime(4) <= 988) {
// PPDD收尾,DD于788极限全收撑杆
At(thisWave + 270) PP();
At(thisWave) EndingHelper({788}, PP());
} else {
// cPP-PP收尾
At(thisWave + 195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40);
At(thisWave + 389) PP(8.75);
At(thisWave) EndingHelper({1150}, PP());
}
};

为什么PPDD波反而要考虑延迟?因为这个状态会用在w10,而大波的普僵进场时间非常晚,401时大量铁桶、铁门仍在可伤域外,在无红关很容易造成延迟。

接下来考虑如何从红眼关阵解过渡到白眼关阵解。分类讨论最后一波红眼所在波次:

  • NDD、(IPP-)PP:本来也要接PPDD,直接转到白眼关阵解的PPDD即可
  • (IPP-PP-)cPP:这波相比主循环的IPP-PP|PPDD省了一对炮,因此也能转白眼关PPDD
  • PPDD:下一波还要处理残余2血红,不能直接转入白眼关。可以先打一波PPI作为过渡,然后转白眼关的PPc
  • IPP:原本要接cPPI,但由于不需要压制下波红眼,可以改打cPP,然后转白眼关PPDD

插一句题外话,虽然这个解考虑了所有状态转白的情况,但如果有的状态不能转,需要接着按原阵解打下一波,状态转移函数也支持这种情况。如果nogiga分支未被指定,则接下来会继续执行activate分支,直到遇到包含nogiga分支的状态为止。

更新后的红眼关阵解如下,增加了nogiga分支和trans_PPI状态:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
// 冰波:IPP-PP 1248
states["hb_IPP"] = {
Transition(659, delay = "hb_(IPP-)PP", activate = "hb_(IPP|)cPPI", WaveIs(8, 18) = "hb_(IPP|)cPPI_w8", nogiga = "trans_cPP", finish = "hb_final"),
At(1) I(),
At(459) P(15, 8.325),
At(1048) PP(8.75), // 1048 = 659 + 389
};
states["hb_(IPP-)PP"] = {
Transition(1248, activate = "hb_PPDD", delay = "hb_(IPP-PP-)cPP", nogiga = "b_PPDD", finish = "hb_final"),
};
// 加速波:PPDD 601
states["hb_PPDD"] = {
Transition(601, activate = "hb_IPP", nogiga = "trans_PPI", finish = "hb_final"),
At(291) PP() & DD<107>(9),
};
// 冰波延迟:IPP-PP-cPP 1739
states["hb_(IPP-PP-)cPP"] = {
Transition(1739, activate = "hb_IPP", nogiga = "b_PPDD", finish = "hb_final"),
At(1300) C.TriggerBy(AGIGA_GARGANTUAR & CURR_WAVE)(266),
At(1539) PP(), // 1539 = 1248 + 291
};
// 冰波意外刷新:IPP|cPPI 659|601
states["hb_(IPP|)cPPI"] = {
Transition(601, activate = "hb_PPDD", nogiga = "b_PPDD", finish = "hb_final"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
At(390) I(),
};
// 如果cPPI波出现在w8,需要调整为cPP|PPIc
states["hb_(IPP|)cPPI_w8"] = {
Transition(601, finish = "hb_final"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
At(next_wave + 401) C.TriggerBy(AGIGA_GARGANTUAR)(800),
};
****
// 转白过渡
states["trans_PPI"] = {
Transition(601, activate = "b_PPc", finish = "b_final"),
At(318) PP(),
At(360) I(),
};
states["trans_cPP"] = {
Transition(601, activate = "b_PPDD", finish = "hb_final"),
At(195) C.TriggerBy(ADANCING_ZOMBIE, ALADDER_ZOMBIE)(40),
};

其他

现在只剩w20了!由于ch6冰平衡过于轻松,我们干脆冰消珊瑚好了:(才不是因为w19不拖的情况下w20不好打呢)

1
2
3
4
5
6
7
OnWave(20) {
At(96) I(),
At(380) P(15, 9), // 热过渡
At(953) PP(), // 全伤巨人
At(1220) PP(), // 全伤撑杆
EndingHelper(PP(), {1600, 2300}),
};

最后还需要启动状态机。红眼关以NDD起手,无红关以PPDD起手:

1
2
3
auto initialState = AGetZombieTypeList()[AGIGA_GARGANTUAR] ? "hb_NDD" : "b_PPDD";
StartTransition(1, initialState);
StartTransition(10, initialState);

完整代码

附赠一个简短的天台十炮脚本,阵解主体只有23行。

总结

本文以双冰16炮键控脚本为例,展示了状态机框架的大部分核心要素。这一方法的主要优势是,使用状态机编写非定态脚本时,只需复制状态机本身的代码,并根据阵解定义新的状态和转移,无需设计复杂的嵌套或回调,也不必写大量重复的刷新检测代码。

键控炮阵冲关仍有一些难点有待解决。以下是我想到的一些,希望本文能够抛砖引玉。

其一是测试较为困难。随机发生的刷新意外和转白波次的不同都会导致轨道改变,因此执行轨迹的种类数会远多于定态演示脚本,人工分析容易有所遗漏。跳帧测试配合回放功能是一个可行的测试手段,但仍然不够高效。

其二是收尾难以系统化。可以看到,文中的阵型完全没有拖收尾。拖收尾是一件很复杂的事,上波残留僵尸、本波出红情况以及场上能垫的位置都需要考虑。笔者暂未想到能够统一大部分阵型收尾的框架。

第一次不依赖大模型用 Lean 证明了一个没那么显然的定理,在此记录一下。写得很 naive,希望将来自己的水平能有所长进吧。

题目:设 \(d(n)\) 表示自然数 \(n\) 在十进制下的各位数字之和。证明:对于任意自然数 \(n,\,k\),若 \(1 \le n \le 10^k\),则有 \(d\left(\left(10^k - 1\right) \cdot n\right) = 9k\).

思路:把 \(\left(10^k - 1\right) \cdot n\) 拆分为高 \(k\) 位和低 \(k\) 位两部分。高 \(k\) 位的值为 \(n - 1\),低 \(k\) 位的值为 \(10^k - n\)。注意到 \((n - 1) + (10^k - n) = 10^k - 1\),因此这两部分的各位数字互补,每一位的数字之和都为 \(9\)。因此总和为 \(9k\)。

代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
import Mathlib

def digitSum (n : ℕ) := (Nat.digits 10 n).sum

theorem digitSum_divmod_10 (n : ℕ) :
digitSum n = digitSum (n / 10) + (n % 10) := by
by_cases hn : n = 0
· simp [hn]
· simp [digitSum]
rw [Nat.digits_eq_cons_digits_div (by decide) hn]
simp [add_comm]

theorem digitSum_eq_self_iff (n : ℕ)
: n < 10 ↔ digitSum n = n := by
constructor
· intro hn
by_cases hn2 : n = 0
· simp [digitSum, hn2]
· simp [digitSum, Nat.digits_of_lt _ _ hn2 hn]
· contrapose!
intro hn
apply Nat.ne_of_lt
rw [digitSum_divmod_10]
nth_rw 3 [← Nat.div_add_mod n 10]
calc digitSum (n / 10) + n % 10
_ ≤ n / 10 + n % 10 := by simp [digitSum, Nat.digit_sum_le]
_ < 10 * (n / 10) + n % 10 := by
have : n / 10 > 0 := Nat.div_pos hn (by decide)
linarith

theorem digitSum_divmod_power_of_10 (n k : ℕ)
: digitSum n = digitSum (n / 10^k) + digitSum (n % 10^k) := by
induction k generalizing n with
| zero => norm_num; simp [Nat.mod_one, digitSum]
| succ k ih =>
-- LHS: digitSum n
-- digitSum n = digitSum n/10^k + digitSum n%10^k
-- digitSum n/10^k = digitSum n/10^(k+1) + n/10^k % 10
rw [ih, digitSum_divmod_10]
rw [Nat.div_div_eq_div_mul, ← Nat.pow_add_one, add_assoc]
-- RHS: digitSum n/10^(k+1) + digitSum n%10^(k+1)
-- digitSum n%10^(k+1) = digitSum n%10^(k+1) / 10^k + digitSum n%10^k
-- n%10^(k+1) / 10^k = n/10^k % 10
nth_rw 4 [ih]
have : 10 ^ k ∣ 10 ^ (k + 1) := Nat.pow_dvd_pow _ (Nat.le_add_right _ _)
rw [Nat.mod_mod_of_dvd _ this]
rw [pow_succ, Nat.mod_mul_right_div_self]
nth_rw 4 [(digitSum_eq_self_iff _).mp]
exact Nat.mod_lt _ (by decide)

lemma complement_divmod_10 {a b k : ℕ} :
a + b = 10 ^ (k + 1) - 1 ↔ a / 10 + b / 10 = 10 ^ k - 1 ∧ a % 10 + b % 10 = 9 := by
constructor
· intro h
have h2: (a % 10 + b % 10) % 10 = 9 := by
rw [← Nat.add_mod, h]
induction k with
| zero => simp
| succ k ih =>
rw [Nat.pow_succ, Nat.mod_eq_sub_iff (c := 1) (by decide) (by decide)]
rw [← Nat.pow_succ, Nat.sub_add_cancel (Nat.one_le_pow _ _ (by decide))]
apply Nat.dvd_mul_left
omega
· rintro ⟨ha, hb⟩
rw [← Nat.div_add_mod' a 10, ← Nat.div_add_mod' b 10]
have : (a / 10 * 10 + a % 10) + (b / 10 * 10 + b % 10)
= (a / 10 + b / 10) * 10 + (a % 10 + b % 10) := by ring
rw [this, ha, hb]
rw [Nat.sub_mul, ← Nat.pow_succ]
have : 10 ≤ 10 ^ (k + 1) := by apply Nat.le_pow; simp
rw [← Nat.sub_add_comm this, Nat.add_sub_add_right]

lemma digitSum_eq_9k_of_complement {a b k : ℕ}
(h : a + b = 10 ^ k - 1) :
digitSum a + digitSum b = 9 * k := by
induction k generalizing a b with
| zero => norm_num at *; simp [digitSum, h]
| succ k ih =>
rw [complement_divmod_10] at h
rw [digitSum_divmod_10 a, digitSum_divmod_10 b]
rw [mul_add_one, ← ih (h.left), ← h.right]
ac_rfl

-- For all natural number n, k such that 1 ≤ n ≤ 10^k, show that the digit sum of (10^k - 1)n is 9k.
example (k : ℕ) (n : ℕ) (hn : 1 ≤ n ∧ n <= 10 ^ k) :
digitSum ((10 ^ k - 1) * n) = 9 * k := by
-- (10^k - 1) * n = 10^k * n - n = (n - 1) * 10^k + (10^k - n)
-- divide the digits into two parts:
-- 1. digitSum ((n - 1) * 10^k) = digitSum (n - 1)
-- 2. digitSum (10^k - n) = digitSum ((10^k - 1) - (n - 1)) = 9 * k - digitSum (n - 1)
let x := (10^k - 1) * n
have hSplit : x / 10^k = n - 1 ∧ x % 10^k = 10^k - n := by
rw [Nat.div_mod_unique (Nat.pow_pos (by decide))]
constructor
· dsimp [x]
zify [hn.left, hn.right, show 1 ≤ 10^k from Nat.one_le_pow _ _ (by decide)]
ring
· exact Nat.sub_lt (Nat.pow_pos (by decide)) hn.left
rw [digitSum_divmod_power_of_10 _ k, hSplit.left, hSplit.right]
apply digitSum_eq_9k_of_complement
rw [← Nat.sub_add_comm hn.left, Nat.add_sub_of_le hn.right]

概述

其后,京兆尹将饰官署,余往过焉。委群材,会众工。或执斧斤,或执刀锯,皆环立向之。梓人左持引,右执杖,而中处焉。量栋宇之任,视木之能举,挥其杖曰:“斧!”彼执斧者奔而右;顾而指曰:“锯!”彼执锯者趋而左。俄而斤者斫,刀者削,皆视其色,俟其言,莫敢自断者。其不胜任者,怒而退之,亦莫敢愠焉。画宫于堵,盈尺而曲尽其制,计其毫厘而构大厦,无进退焉。既成,书于上栋,曰“某年某月某日某建”,则其姓字也。凡执用之工不在列。余圜视大骇,然后知其术之工大矣。
——《梓人传》柳宗元

我花了一周的时间,用 Claude Code 从头搓了一个前端 app。花在项目上的时间大约有 40h。代码总计 14k 行,去除单元测试、注释和空行后约 6k 行。项目的所有代码都是 Claude Code 生成的,我只提供了约 2000 字的初始项目描述和后续开发过程中的 prompt。

总体来说,Claude Code 的表现相当不错,我最担心的界面美观性对它而言其实不是问题。我观察到的比较明显的缺点有:

  • Token 用量过大:通过 API 高强度使用 Claude Code 的话花费能达到 $5/h 级别,这已经和人类实习生的工资在同一个数量级了。
  • 重构能力较弱:对于较大的项目,Claude Code 很难在重构时追踪到所有需要修改的文件,导致重构很难一遍过,需要反复修正。或许换个 prompt 能好点。
  • 处理复杂功能时表现不佳:我本来想让 Claude Code 实现一个 drag & drop,但它死活写不对,只好先放弃了。

瑕不掩瑜,强烈建议需要大量写代码(尤其是前后端、CLI等典型场景)的人试一试 Claude Code。Claude Pro $20/mo 的订阅价格和它的功能相比非常划算。目前 Claude Pro 提供的额度还是很慷慨的,大概能支撑你每 5h 高强度使用(上一条恢复后立刻开始下一条)2h。低强度使用的话根本不需要担心额度问题。

小技巧

以下是我使用 Claude Code 的过程中摸索出来的一些小技巧。

通知

Claude Code 执行一个任务可能需要几分钟,这段时间一直盯着终端有点浪费时间。可以加个 hook,让它在请求权限或任务完成时发送通知。把以下内容写到 ~/.claude/settings.json 中即可。(非 Linux 系统请自行修改命令)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
{
"hooks": {
"Notification": [
{
"matcher": "",
"hooks": [
{
"type": "command",
"command": "jq -r \"\\\"notify-send -a 'Claude Code' 'Notification' '\\(.message)'\\\"\" | bash"
}
]
}
],
"Stop": [
{
"matcher": "",
"hooks": [
{
"type": "command",
"command": "notify-send -a 'Claude Code' 'Task Finished' 'Claude is waiting for your input'"
}
]
}
]
}
}

Playwright MCP

Playwright MCP 可以让 Claude Code 以 a11y tree 的形式访问网页并操作,这样它就可以自动测试网页了。执行以下命令以添加:

1
claude mcp add playwright -- npx @playwright/mcp@latest --executable-path /usr/bin/chromium --isolated --headless

浏览复杂网页时 token 用量不小,按量计费时需要注意。

Think

在 Claude Code 中,思维链模式需要通过特定关键词触发。

These specific phrases are mapped directly to increasing levels of thinking budget in the system: "think" < "think hard" < "think harder" < "ultrathink." Each level allocates progressively more thinking budget for Claude to use.

在实现复杂功能之前,开启 plan mode 并加入 ultrathink 关键词可以让 Claude Code 先思考出一个详细的计划。

中途输入

你可以在任何时刻向 Claude Code 提供输入,它会在完成下一次工具交互后读入这些内容。比如你发现它犯错后,你可以及时纠正,而不需停止整个任务。

继续对话

claude --resume 可以选择一个之前的对话继续进行。claude --continue 会继续最近的对话。

过长的对话会增大 token 用量。适时清空上下文或者使用 /compact 命令可以减少花费。

软件工程

TBD

0%